How-To
Audit Bias Fairness
How to Audit AI Systems for Bias and Safety
Comprehensive guide to conducting technical audits of AI models for fairness, safety, and reliability.
AI World News Weekly Editorial Team
6 min read

Regular audits ensure AI systems remain fair, safe, and reliable. This guide provides a comprehensive audit framework.
Step 1: Establish Audit Baseline
Define what you’re measuring:
class ModelAudit:
    def __init__(self, model, test_data):
        self.model = model
        self.test_data = test_data
        self.baseline = self.establish_baseline()

    def establish_baseline(self):
        return {
            'accuracy': self.calculate_accuracy(),
            'precision': self.calculate_precision(),
            'recall': self.calculate_recall(),
            'f1_score': self.calculate_f1(),
            'demographic_parity': self.calculate_demographic_parity()
        }

    def print_baseline(self):
        for metric, value in self.baseline.items():
            print(f"{metric}: {value:.4f}")
Step 2: Test for Bias
Gender Bias Detection
def detect_gender_bias(model, test_data):
    male_data = test_data[test_data['gender'] == 'M']
    female_data = test_data[test_data['gender'] == 'F']

    male_accuracy = evaluate_accuracy(model, male_data)
    female_accuracy = evaluate_accuracy(model, female_data)

    gender_bias = abs(male_accuracy - female_accuracy)

    return {
        'male_accuracy': male_accuracy,
        'female_accuracy': female_accuracy,
        'bias': gender_bias,
        'status': 'PASS' if gender_bias < 0.05 else 'FAIL'
    }
Racial Bias Detection
def detect_racial_bias(model, test_data):
    results = {}

    for race in test_data['race'].unique():
        race_data = test_data[test_data['race'] == race]
        accuracy = evaluate_accuracy(model, race_data)
        results[race] = accuracy

    # Calculate disparity
    max_accuracy = max(results.values())
    min_accuracy = min(results.values())
    disparity = max_accuracy - min_accuracy

    return {
        'by_race': results,
        'disparity': disparity,
        'status': 'PASS' if disparity < 0.05 else 'FAIL'
    }
Age Bias Detection
def detect_age_bias(model, test_data):
    age_groups = [
        (18, 25), (26, 35), (36, 45), (46, 55), (56, 65), (65, 100)
    ]

    results = {}

    for low, high in age_groups:
        group_data = test_data[(test_data['age'] >= low) & (test_data['age'] < high)]
        accuracy = evaluate_accuracy(model, group_data)
        results[f'{low}-{high}'] = accuracy

    disparity = max(results.values()) - min(results.values())

    return {
        'by_age_group': results,
        'disparity': disparity
    }
Step 3: Fairness Metrics
Demographic Parity
def demographic_parity(model, test_data, protected_attr, target='positive'):
    """
    Checks if positive prediction rate is equal across groups
    """
    groups = test_data[protected_attr].unique()
    positive_rates = {}

    for group in groups:
        group_data = test_data[test_data[protected_attr] == group]
        predictions = model.predict(group_data)
        positive_rate = (predictions == target).sum() / len(predictions)
        positive_rates[group] = positive_rate

    # Calculate parity
    max_rate = max(positive_rates.values())
    min_rate = min(positive_rates.values())
    parity = min_rate / max_rate if max_rate > 0 else 1.0

    return {
        'positive_rates': positive_rates,
        'parity_ratio': parity,
        'status': 'PASS' if parity > 0.8 else 'FAIL'  # 80/20 rule
    }
Equalized Odds
def equalized_odds(model, test_data, protected_attr, target):
    """
    Checks if true positive rate and false positive rate are equal across groups
    """
    groups = test_data[protected_attr].unique()
    tpr_by_group = {}
    fpr_by_group = {}

    for group in groups:
        group_data = test_data[test_data[protected_attr] == group]
        predictions = model.predict(group_data)

        # True Positive Rate
        tp = ((predictions == target) & (group_data['label'] == target)).sum()
        p = (group_data['label'] == target).sum()
        tpr = tp / p if p > 0 else 0
        tpr_by_group[group] = tpr

        # False Positive Rate
        fp = ((predictions == target) & (group_data['label'] != target)).sum()
        n = (group_data['label'] != target).sum()
        fpr = fp / n if n > 0 else 0
        fpr_by_group[group] = fpr

    # Calculate disparity
    tpr_disparity = max(tpr_by_group.values()) - min(tpr_by_group.values())
    fpr_disparity = max(fpr_by_group.values()) - min(fpr_by_group.values())

    return {
        'tpr_by_group': tpr_by_group,
        'fpr_by_group': fpr_by_group,
        'tpr_disparity': tpr_disparity,
        'fpr_disparity': fpr_disparity
    }
Step 4: Safety Testing
Adversarial Robustness
def test_adversarial_robustness(model, test_data):
    from adversarial.attacks import FGSM

    attack = FGSM(epsilon=0.1)
    adversarial_data = attack.generate(test_data)

    clean_accuracy = evaluate_accuracy(model, test_data)
    adversarial_accuracy = evaluate_accuracy(model, adversarial_data)

    robustness = adversarial_accuracy / clean_accuracy

    return {
        'clean_accuracy': clean_accuracy,
        'adversarial_accuracy': adversarial_accuracy,
        'robustness': robustness,
        'status': 'PASS' if robustness > 0.8 else 'FAIL'
    }
Edge Cases
def test_edge_cases(model, test_data):
    results = {}

    # Test with missing values
    missing_data = test_data.copy()
    missing_data.iloc[0, 0] = None
    try:
        predictions = model.predict(missing_data)
        results['missing_values'] = 'PASS'
    except Exception as e:
        results['missing_values'] = f'FAIL: {e}'

    # Test with extreme values
    extreme_data = test_data.copy()
    extreme_data.iloc[0] = extreme_data.max() * 1000
    try:
        predictions = model.predict(extreme_data)
        results['extreme_values'] = 'PASS'
    except Exception as e:
        results['extreme_values'] = f'FAIL: {e}'

    # Test with empty input
    try:
        predictions = model.predict(test_data[:0])
        results['empty_input'] = 'PASS'
    except Exception as e:
        results['empty_input'] = f'FAIL: {e}'

    return results
Step 5: Performance Audit
Consistency Check
def test_consistency(model, test_data, num_runs=10):
    """
    Test if model produces consistent predictions for same input
    """
    first_input = test_data.iloc[0]

    predictions = []
    for _ in range(num_runs):
        pred = model.predict([first_input])
        predictions.append(pred[0])

    unique_predictions = set(predictions)
    consistency = (len(unique_predictions) == 1)

    return {
        'predictions': predictions,
        'consistent': consistency,
        'status': 'PASS' if consistency else 'FAIL'
    }
Calibration Check
def test_calibration(model, test_data):
    """
    Check if confidence scores match actual accuracy
    """
    predictions, confidences = model.predict_with_confidence(test_data)

    # Group by confidence bins
    bins = [0.0, 0.5, 0.6, 0.7, 0.8, 0.9, 1.0]
    calibration = {}

    for i in range(len(bins) - 1):
        lower, upper = bins[i], bins[i + 1]
        mask = (confidences >= lower) & (confidences < upper)

        if mask.sum() > 0:
            accuracy = (predictions[mask] == test_data.iloc[mask]['label']).mean()
            avg_confidence = confidences[mask].mean()

            calibration[f'{lower:.1f}-{upper:.1f}'] = {
                'confidence': avg_confidence,
                'accuracy': accuracy,
                'calibration_error': abs(accuracy - avg_confidence)
            }

    return calibration
Step 6: Create Audit Report
def generate_audit_report(model, test_data):
    report = {
        'timestamp': datetime.now(),
        'model_id': model.id,
        'performance': evaluate_performance(model, test_data),
        'bias_assessment': {
            'gender': detect_gender_bias(model, test_data),
            'race': detect_racial_bias(model, test_data),
            'age': detect_age_bias(model, test_data)
        },
        'fairness_metrics': {
            'demographic_parity': demographic_parity(model, test_data, 'race'),
            'equalized_odds': equalized_odds(model, test_data, 'race', 'positive')
        },
        'safety_tests': {
            'adversarial_robustness': test_adversarial_robustness(model, test_data),
            'edge_cases': test_edge_cases(model, test_data),
            'consistency': test_consistency(model, test_data),
            'calibration': test_calibration(model, test_data)
        },
        'recommendations': generate_recommendations(report)
    }

    return report
Audit Checklist
Performance Audit
□ Accuracy on all data splits
□ Precision, recall, F1 scores
□ ROC-AUC scores
□ Performance on imbalanced classes

Fairness Audit
□ Demographic parity across groups
□ Equal opportunity/equalized odds
□ Calibration within groups
□ Representation in training data

Safety Audit
□ Adversarial robustness
□ Edge case handling
□ Prediction consistency
□ Confidence calibration
□ Handling of missing data

Compliance Audit
□ Data usage compliance
□ Documentation completeness
□ Monitoring implementation
□ Incident response readiness
Audit Frequency
- Critical models: Monthly
- High-impact models: Quarterly
- Standard models: Semi-annually
- Low-risk models: Annually
Conclusion
Regular, systematic audits ensure AI systems remain fair, safe, and reliable. Implement this framework to maintain high standards for your AI deployments.
Sources & References
Official Frameworks
- NIST AI Risk Management Framework - https://www.nist.gov/ai-risk-management-framework
- IEEE Standards for AI - https://standards.ieee.org/
- ISO/IEC AI Standards - https://www.iso.org/
Research & Education
- Fairness and Machine Learning (Book) - https://fairmlbook.org/
- Partnership on AI - https://partnershiponai.org/
- Center for AI Safety - https://www.safe.ai/
Tools & Implementation
- Scikit-learn Documentation - https://scikit-learn.org/
- TensorFlow Model Evaluation - https://www.tensorflow.org/
- MLflow - Model Management - https://mlflow.org/
Best Practices
- Responsible AI Implementation - https://www.microsoft.com/en-us/ai/responsible-ai
- Google AI Ethics - https://www.google.com/ai/responsibility/
Related Articles
How-To
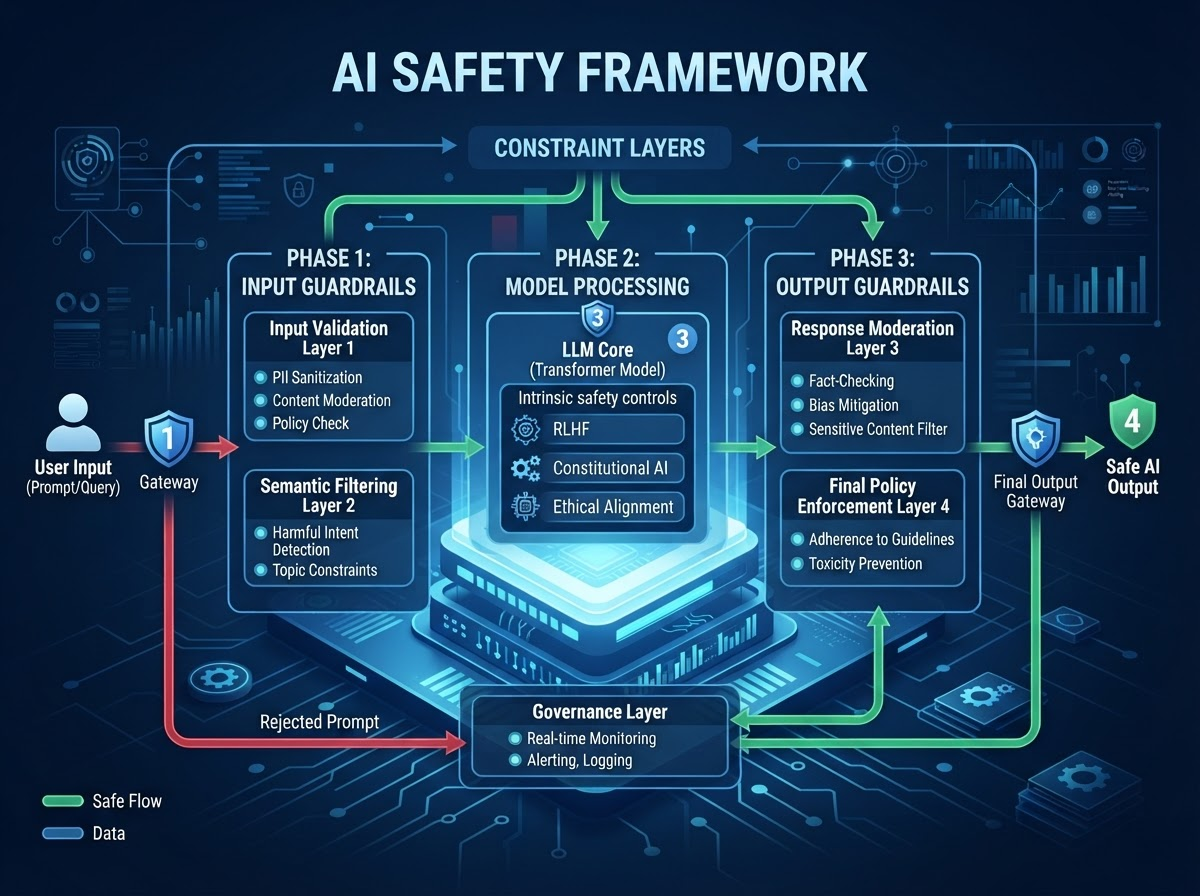
How to Build and Test AI Safety Guardrails
Practical guide to implementing safety constraints and testing mechanisms for AI systems.
How-To
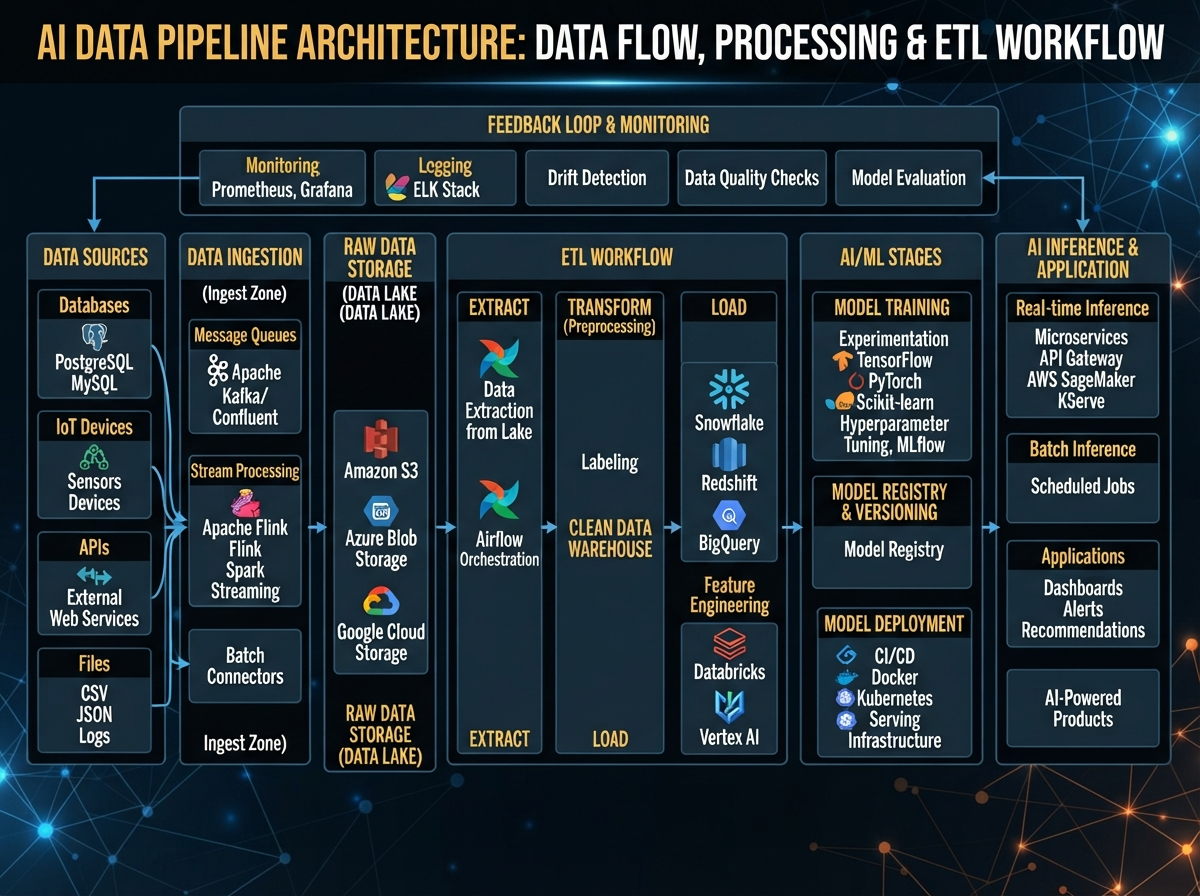
How to Build Scalable AI Data Pipelines
Step-by-step guide to building production-ready data pipelines for machine learning.
How-To
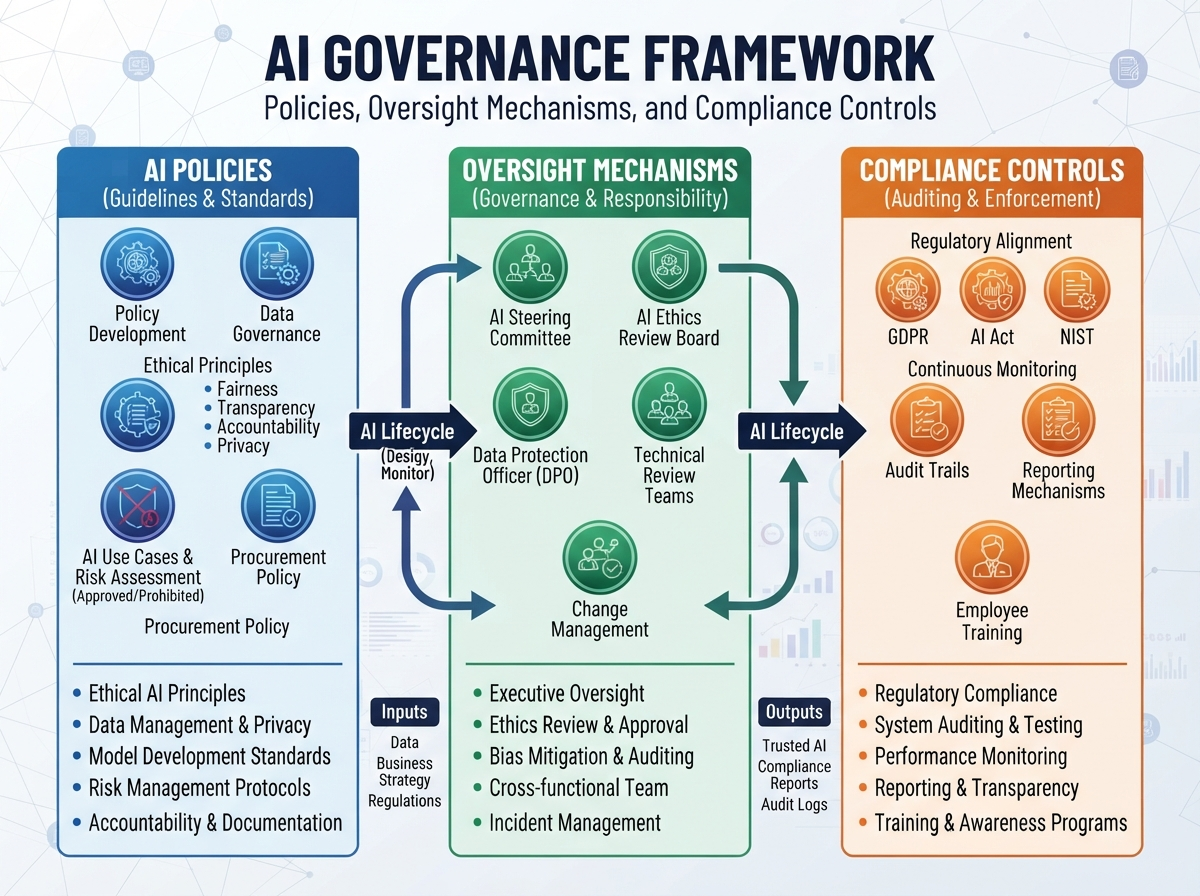
How to Implement AI Governance Frameworks
Comprehensive guide to establishing governance policies and oversight for AI systems.